HotStuff: de cero a estado del arte
Artículo 44 de 47
94%
completado al llegar aquí
Sistemas distribuidosNota de investigación13 min de lectura
BFT y Agentes de IA: Coordinar decisiones de modelos LLM sin punto de falla
Qué significa tratar a un agente LLM que falla o miente como réplica bizantina: votos, quórums, verificación y lo que afirman dos preprints de 2025.
Ruta HotStuff: 0/47
Prerequisitos recomendados
Si alguno de estos conceptos todavía está medio nebuloso, empieza por aquí. Te ahorra tropiezos y un par de cejas fruncidas.
Traslada las ideas de tolerancia a fallas bizantinas a sistemas con varios agentes LLM: qué es un agente bizantino, cuándo sirve votar, por qué el no determinismo complica los quórums y qué proponen dos preprints de 2025 todavía sin revisión por pares.
- Consenso BFT desde cero (bft-consensus-from-zero)
- Quórums en acción (quorums-en-accion-mayorias-honestas)
Detente cuando puedas explicar qué supuesto de la votación clásica rompen los LLM, en qué se diferencian un quórum de respuestas idénticas y una agregación robusta de puntuaciones, y por qué superar f < n/3 en esos preprints no contradice la teoría.
Glosario de Notación Matemática y Criptográfica
Cantidad de réplicas maliciosas o con fallas arbitrarias que tolera el sistema.
n = 3f + 1Ruta mental: de réplicas a agentes
Modelo de fallas
Agente bizantino
Condición de voto
Salidas comparables
Agregación
Contar o puntuar
Evidencia
Preprints
Decodificador Didáctico de Conceptos BFT
En palabras simples: Un perito que, en vez de equivocarse de forma honesta, entrega informes distintos a cada parte o inventa datos con aplomo.
Detalle técnico: Participante cuyo comportamiento no está restringido: puede omitir, contradecirse o coludir; el modelo no pregunta por la intención, solo por lo observable.
En palabras simples: En un jurado de cata, descartar la influencia del juez que pone 100 a su amigo y 0 a todos los demás usando la mediana en lugar del promedio.
Detalle técnico: Combinar evaluaciones de varios agentes con un estadístico que no puede ser arrastrado arbitrariamente por una minoría de entradas adversarias.
Cada vez más sistemas encadenan varios agentes basados en modelos de lenguaje: uno propone, otro revisa, un tercero ejecuta. La pregunta natural para quien viene de sistemas distribuidos es si las ideas de tolerancia a fallas bizantinas sirven aquí. Si un agente puede responder con seguridad algo falso, o puede estar controlado por alguien con otros intereses, ¿no es exactamente el traidor de los generales bizantinos?
La respuesta corta es que el vocabulario encaja muy bien y las garantías no se trasladan solas. Este capítulo separa las dos cosas. Primero fija la teoría establecida; después presenta dos trabajos recientes que la aplican a agentes LLM, con una advertencia que repetiremos donde haga falta: ambos son preprints de 2025 que todavía no han pasado revisión por pares, así que sus resultados son afirmaciones de sus autores, no hechos consolidados.
Un agente que miente es una réplica bizantina
En el problema de los generales bizantinos, los traidores no tienen ninguna restricción de comportamiento: pueden enviar valores distintos a distintos participantes o callar, y el objetivo es que los leales acuerden igualmente. [1] Lamport, Shostak y Pease presentan el problema como una cuestión de sistemas fiables: componentes que fallan entregando información contradictoria a distintas partes. [1] El modelo no distingue entre un error y un ataque; solo mira el comportamiento observable.
Con esa lente, un agente LLM que alucina un dato, uno cuya instrucción fue manipulada y uno operado por un tercero hostil caen en la misma categoría: participantes cuyas salidas no se pueden asumir correctas. Lo que cambia entre ellos es la distribución de sus errores, no el modelo.
La teoría también fija el precio. Con mensajes orales, que pueden alterarse al retransmitirse, ningún algoritmo resuelve el acuerdo si un tercio o más de los generales son traidores; hacen falta más de generales para tolerar . [1] Con mensajes firmados y un modelo síncrono, el mismo trabajo muestra que el acuerdo es posible con cualquier número de traidores. [1] PBFT convierte el caso práctico en ingeniería: réplicas toleran bizantinas sin suponer sincronía para la safety. [2]
La condición que la votación necesita
Hay un supuesto que suele pasarse por alto. Lamport, Shostak y Pease dedican una sección a construir sistemas fiables con varios procesadores que calculan lo mismo y votan por mayoría, y subrayan la condición clave: todos los procesadores correctos deben usar la misma entrada. [1] Si las entradas difieren, la mayoría deja de significar algo.
PBFT añade la otra mitad: las réplicas se modelan como máquinas de estado deterministas, de modo que la misma operación sobre el mismo estado produce el mismo resultado. [2] Gracias a eso, un cliente puede aceptar un resultado cuando recibe respuestas iguales de réplicas distintas, porque al menos una proviene de una réplica correcta. [2]
Los LLM rompen ese supuesto. Dos agentes correctos con la misma pregunta pueden producir textos distintos, y a veces respuestas distintas. Un quórum de "salidas idénticas" no se forma aunque nadie mienta. Las alternativas son dos. La primera es canonizar la salida, por ejemplo extrayendo un número o una opción de una lista, para que respuestas equivalentes se comparen como iguales. La segunda es dejar de contar coincidencias y pasar a puntuar: evaluar la calidad de cada respuesta y agregar esas evaluaciones de forma robusta. Los dos preprints que siguen ilustran cada camino.
Dos preprints, dos estrategias
Confianza como peso del voto. Zheng y coautores estudian sistemas multiagente con LLM bajo la lente de tolerancia a fallas bizantinas; se trata de un preprint en arXiv aún no revisado por pares. [3] En un experimento piloto con redes de 7 agentes en seis topologías (cadena, árbol, estrella, grafo completo, aleatorio y por capas), comparan agentes tradicionales con agentes LLM sobre problemas matemáticos (GSM8K) y de evaluación de seguridad (XSTest), usando 10 preguntas por tarea. [3] Afirman que los agentes tradicionales colapsan con dos o tres nodos maliciosos, mientras que los agentes LLM mantienen buen desempeño incluso con 6 de 7 maliciosos, y lo atribuyen a que los LLM muestran más escepticismo ante mensajes erróneos. [3]
A partir de ahí proponen CP-WBFT, un consenso ponderado por confianza. La confianza de cada agente se estima con una pregunta explícita en el prompt o con una sonda lineal entrenada sobre representaciones internas del modelo; luego cada agente adopta la respuesta de un vecino si este declara más confianza, y el sistema elige la respuesta con mayor confianza promedio. [3] Los autores reportan que la variante con sonda interna alcanza 100 % de acierto final en grafos completos en ambas tareas con 6 agentes bizantinos de 7. [3]
Puntuar todas las respuestas, sin líder. Jo y Park, también en un preprint sin revisión por pares, parten de una crítica a los esquemas con líder: si varios líderes seguidos son bizantinos, cada ronda fallida repite una invocación costosa de LLM, y un quórum que vota sí o no sobre la propuesta del líder puede aceptar una respuesta mediocre aunque existan mejores. [4] Su sistema, DecentLLMs, separa workers que generan respuestas en paralelo de evaluators que las puntúan, como muestra la figura. [4]
Agregación robusta de puntuaciones entre agentes LLM
Fuentes:
[4]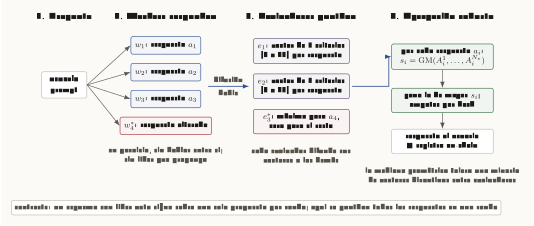
Cómo leer esta figura
Cuatro pasos de izquierda a derecha. Un usuario envía un prompt a cuatro workers; tres producen respuestas a1, a2 y a3 y el cuarto, bizantino, una respuesta alterada; responden en paralelo y sin líder. Las respuestas llegan por difusión fiable a tres evaluadores; dos asignan a cada respuesta un vector de cinco criterios entre 0 y 20, y el tercero, bizantino, da el máximo a la respuesta alterada y cero al resto; cada evaluador difunde sus vectores. Para cada respuesta se calcula la mediana geométrica de los vectores, gana la de mayor puntuación con desempate por hash, y el resultado se entrega al usuario y se registra on-chain. Una nota inferior contrasta este esquema con uno basado en líder, que vota sí o no sobre una sola propuesta por ronda.
Cada evaluador asigna a cada respuesta un vector de cinco criterios, como contradicción factual, invención de hechos o incoherencia lógica, en una escala de 0 a 20. [4] Los vectores se difunden con un protocolo de difusión fiable bizantina, y cada evaluador calcula por respuesta la mediana geométrica, que según los autores tolera hasta vectores bizantinos; gana la respuesta con mayor puntuación agregada. [4]
Con 100 problemas del benchmark MMLU-Pro, reportan 71 respuestas correctas frente a 64 de un quórum de dos tercios y 50 de una mayoría simple, aunque la comparación supone que la propuesta del líder ocupa una posición fija en el ranking de calidad. [4] En latencia, simulando los patrones de comunicación de los esquemas con líder en su peor caso, afirman que DecentLLMs se mantiene cerca de 221 segundos sin importar cuántos agentes bizantinos haya, mientras que las alternativas crecen casi linealmente. [4]
Leer sus resultados sin perder el modelo de fallas
Zheng y coautores presentan sus resultados como una superación del límite clásico . [3] Conviene ser preciso, porque no hay contradicción con la teoría: se trata de otro problema. En el problema de los generales, la orden en juego, atacar o retirarse, no trae en su contenido ninguna prueba de ser la correcta, y la imposibilidad se apoya en que un teniente leal no puede distinguir en qué escenario está. [1] En un problema de aritmética con respuesta verificable, en cambio, un agente capaz puede descartar una respuesta errónea aunque la repitan seis vecinos. Nuestra lectura es que eso se parece más a verificar que a acordar.
Además, en esos experimentos los agentes "bizantinos" son en buena medida modelos más débiles emparejados con otros más fuertes, por ejemplo GPT-3.5-turbo frente a GPT-4o-mini, sobre preguntas elegidas para que los débiles fallen. [3] Es un adversario útil para estudiar errores, pero no el adversario arbitrario y coordinado del modelo bizantino. Con 10 preguntas por tarea, además, cada porcentaje se apoya en muy pocos casos.
DecentLLMs hace supuestos explícitos que también hay que leer: red síncrona con retardo máximo conocido, firmas seguras y mayoría honesta tanto entre workers como entre evaluadores. [4] Esa combinación encaja con el resultado clásico de que, con firmas y sincronía, el umbral de un tercio deja de ser obligatorio. [1] En una red con retardos arbitrarios antes de estabilizarse, el umbral vuelve a ser , que es lo que asume PBFT. [2] Los propios autores muestran un límite adicional: en un ejemplo, los evaluadores puntuaron por encima una respuesta incorrecta y por debajo una correcta, y señalan la fiabilidad de la evaluación como trabajo pendiente. [4]
Qué tomar para un diseño propio
De la teoría establecida salen tres reglas que no dependen de ningún preprint. Primero, define qué cuenta como la misma respuesta antes de votar; sin salidas comparables no hay quórum posible. [1] Segundo, separa el orden de la decisión de la decisión misma: si varios agentes deben ejecutar acciones con efectos, necesitan acordar qué acción y en qué orden, que es el problema que resuelven PBFT y su familia. [2] Tercero, escribe tu modelo de fallas: cuántos agentes pueden fallar, si la red es síncrona y si los fallos pueden estar correlacionados.
Ese último punto es el más delicado con LLM. La cuenta supone fallas independientes hasta el umbral. Si todos los agentes usan el mismo modelo, el mismo prompt y los mismos datos de entrada, un único error puede afectarlos a la vez, y el umbral se supera sin que ningún agente sea malicioso. Esta es una observación de diseño nuestra, no un resultado de los trabajos citados, pero sigue directamente del modelo de fallas.
De los preprints sale una idea prometedora y todavía por confirmar: cuando la calidad de una respuesta se puede evaluar, puntuar todas las respuestas y agregar con un estadístico robusto puede funcionar mejor que votar sí o no sobre una sola propuesta. [4] Usar la confianza de cada agente como peso es otra línea interesante, con la salvedad de que un agente adversario también puede declarar confianza alta. [3]
Checklist: BFT para agentes LLM
4 de 4 revisados
Bibliografía académica
- [1]
L. Lamport, R. Shostak, and M. Pease, "The Byzantine Generals Problem," ACM TOPLAS, vol. 4, no. 3, pp. 382-401, 1982, doi: 10.1145/357172.357176
Modelo de fallas bizantinas, umbrales con mensajes orales y firmados, y voto mayoritario con entradas iguales.
- [2]
M. Castro and B. Liskov, "Practical Byzantine Fault Tolerance," OSDI, 1999.
Réplicas deterministas, n = 3f + 1 y aceptación de f + 1 respuestas iguales.
- [3]
L. Zheng, J. Chen, Q. Yin, J. Zhang, X. Zeng, and Y. Tian, "Rethinking the Reliability of Multi-agent System: A Perspective from Byzantine Fault Tolerance," arXiv:2511.10400, 2025.
Preprint sin revisión por pares: experimentos piloto por topología y consenso CP-WBFT ponderado por confianza.
- [4]
Y. Jo and C. Park, "Byzantine-Robust Decentralized Coordination of LLM Agents," arXiv:2507.14928, 2025.
Preprint sin revisión por pares: DecentLLMs, evaluación sin líder y agregación con mediana geométrica.
Siguiente lectura
Para repasar por qué votos sobre réplicas se cruzan siempre en una réplica correcta, vuelve a Quórums en acción. Si te interesa cómo cambian las garantías cuando el adversario pueda llegar a romper la criptografía de las firmas, continúa con Criptografía post-cuántica en BFT.
Rutas vecinas
Si este tema te abrió hambre, sigue por aquí.
Series y labs que comparten área o dependen de esta ruta. Pocas opciones, para no convertir la curiosidad en menú infinito.
Series relacionadas
Ethereum: de historia a labs
Serie progresiva para entender Ethereum desde el whitepaper, forks y The Merge hasta EVM, Solidity, proof-of-stake, rollups, account abstraction, DeFi, observabilidad y laboratorios reproducibles.
Substrate: del runtime al consenso propio
Serie de 20 capítulos, de neófito a experto, sobre Substrate (Polkadot SDK): runtime en Wasm, FRAME, extrinsics, estado, pesos, actualizaciones sin fork, Aura, BABE, GRANDPA, sincronización, parachains, XCM, Sassafras, BEEFY y cómo conectar un consenso BFT propio a un nodo.
Ruta práctica: activos digitales en la operación
Nueve módulos, de menor a mayor dependencia, para decidir cómo usar custodia, wallets, llaves, firmas multifirma y MPC, AML/KYT y stablecoins con Fireblocks, BitGo, Kaleido, Circle y Tether.
Labs para convertir lectura en práctica
Prueba de trabajo y reajuste de dificultad
Laboratorio determinista para medir el costo de la prueba de trabajo y ver cómo el reajuste por altura de bloque estabiliza el tiempo entre bloques.
Consensus benchmark
Banco reproducible para comparar consenso BFT y documentar los trade-offs de HotStuff-2.
Ethereum local: Anvil, wallet y primera transacción
Laboratorio base para levantar una red local, crear cuentas, firmar transacciones y observar receipts sin gastar ETH real.
RPC y Cast: leer Ethereum con lupa
Ejercicios con JSON-RPC y Cast para consultar bloques, nonces, gas, receipts, logs y errores reproducibles.
Sigue leyendo
Ideas conectadas con este artículo
Una ruta corta para continuar sin abrir veinte pestañas y perder el hilo.
BFT en Computación en el Borde (Edge/IoT): Consenso con conectividad intermitente
Qué cuesta el consenso bizantino en dispositivos IoT y qué propone EBRC: comité elegido por reputación y VRF, votación en dos fases y una evaluación limitada.
Gobernanza On-Chain y Votos BFT: Actualizar parámetros por consenso
Cómo cambiar parámetros de un protocolo con transacciones ordenadas por el propio consenso BFT: activación determinista, código en el estado y límites reales.
Consenso BFT desde cero: réplicas, quórums y fallas bizantinas
Primer paso de la serie HotStuff: qué problema resuelve BFT, por qué aparece n >= 3f + 1 y cómo separar safety de liveness sin drama matemático.
Uno, dos y tres chains: la taxonomía de commit antes de HotStuff
Guía para entender commits de una, dos y tres cadenas, y cómo esa taxonomía prepara QC, highQC, multipipeline y Fast-HotStuff.