HotStuff: de cero a estado del arte
Artículo 11 de 47
23%
completado al llegar aquí
Sistemas distribuidosNota de investigación14 min de lectura
¿Por qué no podemos usar timeouts fijos (Δ)? Los riesgos de liveness
Por qué un timeout fijo puede dejar sin progreso a un protocolo BFT bajo sincronía parcial y cómo el backoff y el pacemaker recuperan la liveness tras GST.
Ruta HotStuff: 0/47
Comprende por qué un tiempo de espera fijo puede impedir indefinidamente el progreso de un protocolo BFT bajo sincronía parcial y cómo el ajuste dinámico de temporizadores, coordinado por un pacemaker, recupera la liveness.
- Consenso BFT desde cero (bft-consensus-from-zero)
- Sincronía parcial y quórums (partial-synchrony-quorums-bft)
Detente cuando puedas explicar la paradoja del 'cambio de vista infinito' provocada por un timeout estático demasiado corto y por qué un timeout creciente la evita después de GST.
Glosario de Notación Matemática y Criptográfica
Definición conceptual para Δ dentro del contexto de consenso BFT.
Ruta mental de los Riesgos de Timeouts Fijos
Timeout Estático Fijo
T_v = T constante
Red Lenta (latencia > T)
Mensaje llega en T + ε
Disparo Prematuro
Cambio de vista de v a v+1
Bucle Infinito
Cero progreso (livelock)
Decodificador Didáctico de Conceptos BFT
En palabras simples: Un profesor que da 5 minutos para resolver un examen de 10 páginas. Cuando pasan 5 minutos, retira el examen a todos los alumnos sin importar lo preparados que estén. Nadie aprueba, y repetir el examen con el mismo límite no cambia el resultado.
Detalle técnico: Falla de liveness provocada cuando el temporizador fijo T es menor que la latencia real de la red, impidiendo a los nodos correctos completar la votación.
En palabras simples: El profesor nota que nadie terminó en 5 minutos y duplica el tiempo a 10, luego a 20. Eventualmente el tiempo es suficiente y todos entregan su examen.
Detalle técnico: Estrategia de pacemaker que escala T_{v+1} = T_v · γ para que T_v supere, en una cantidad finita de vistas, la latencia real posterior a GST.
A primera vista, la solución más intuitiva para programar un protocolo de consenso es definir una constante en el código fuente:
const CONFIG_TIMEOUT_MS = 3000; // 3 segundos fijosEse número es una apuesta sobre la red. En este artículo veremos por qué la apuesta puede perderse para siempre, cómo esa pérdida produce un livelock en el que el protocolo nunca viola safety pero tampoco confirma nada, y cómo un pacemaker con timeouts crecientes recupera el progreso.
Un timeout es una apuesta sobre una cota desconocida
El modelo de sincronía parcial de Dwork, Lynch y Stockmeyer tiene dos variantes. En una, existe una cota para la entrega de mensajes, pero los procesos no la conocen. En la otra, es conocida, pero solo se cumple a partir de un instante desconocido llamado GST (Global Stabilization Time). [1] Antes de ese punto, la red puede retrasar mensajes tanto como quiera.
Conviene separar dos símbolos que a menudo se confunden. es una propiedad de la red: cuánto tarda, como máximo, un mensaje entre réplicas correctas una vez estabilizada. es una decisión de ingeniería: cuánto espera una réplica antes de abandonar la vista actual. Escribir CONFIG_TIMEOUT_MS = 3000 equivale a afirmar que es suficiente para cubrir todo lo que una vista necesita, es decir, la propuesta, los votos y su agregación, medidos en múltiplos de .
Si esa afirmación es falsa, el protocolo no se equivoca de bloque: la safety de PBFT y de HotStuff se apoya en quórums y certificados, no en relojes. [2] [3] Lo que se pierde es otra cosa: la garantía de que alguna vista termine con un bloque confirmado.
La trampa del cambio de vista infinito
Imaginemos una red de nodos donde el protocolo exige votos. Hemos fijado un timeout rígido de . Una congestión sostenida eleva la latencia entre validadores a . Para simplificar, supongamos que una vista solo necesita que la propuesta llegue a tiempo; con votos y agregación la cuenta empeora, pero el argumento es idéntico.
Veamos la secuencia de eventos:
- Vista 1: el líder correcto genera una propuesta válida para el bloque en y la difunde.
- Tránsito: la propuesta tardará en llegar a las réplicas.
- Timeout en : los temporizadores expiran. Las réplicas sospechan de , envían su mensaje
new-viewy avanzan a la vista 2. - Llegada en : la propuesta de llega, pero las réplicas ya están en la vista 2 y la descartan por pertenecer a una vista anterior.
- Vista 2: el nuevo líder propone en torno a . Su propuesta llega en , pero el temporizador de la vista 2 expira en .
- Repetición: el patrón se reproduce en la vista 3, la 4 y todas las siguientes mientras se mantenga por encima de .
El bucle infinito de timeouts estáticos
Fuentes:
[1]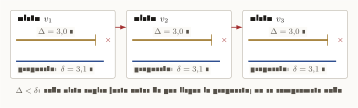
Cómo leer esta figura
El diagrama de carriles muestra vistas consecutivas v1, v2 y v3. En cada vista, la propuesta enviada por el líder tarda δ = 3.1s. La ventana de timeout expira en 3.0s, provocando un cambio de vista antes de procesar el voto. La cadena de bloques permanece vacía indefinidamente.
Este fenómeno se denomina livelock: el sistema está activo, intercambia mensajes y cambia de líder, pero no progresa. Safety se conserva por completo, porque nadie confirmó un bloque incorrecto; el throughput, en cambio, es cero. Desde fuera es indistinguible de un sistema caído, y por eso suele diagnosticarse tarde.
Ojo con un detalle: el problema no es que todos los líderes sean lentos, sino que el protocolo no aprende del fracaso. Cada vista repite exactamente la misma apuesta con el mismo resultado.
Por qué ninguna constante es segura para liveness
¿No bastaría con elegir un generoso, por ejemplo ? Depende de la variante del modelo. Si es conocida y solo falta esperar a GST, un timeout fijo calculado a partir de funciona después de GST. [1] El riesgo aparece en la variante en que existe pero nadie la conoce: para cualquier constante elegida de antemano, existen ejecuciones válidas del modelo en las que la latencia real supera a indefinidamente, y en todas ellas se repite el bucle anterior.
En sistemas reales la distinción no es académica. El operador no conoce ; la estima a partir de mediciones pasadas, y la red cambia por despliegues en nuevas regiones, por congestión o por un adversario que ralentiza tráfico de forma selectiva. Un valor que era cómodo durante las pruebas se vuelve insuficiente en producción.
El argumento contrario también importa. Un fijo enorme sí evita el livelock por latencia, pero cobra un precio en cada falla del líder: si el líder de la vista está caído, todas las réplicas correctas esperan el timeout completo antes de reemplazarlo. Un timeout fijo obliga entonces a elegir entre dos fallos: demasiado corto produce livelock; demasiado largo convierte cada líder caído en una pausa larga. Ninguna constante resuelve ambos extremos a la vez.
Backoff: dejar que el timeout alcance la cota desconocida
La salida clásica es dejar de tratar el timeout como una constante y convertirlo en un estado local que reacciona a los fracasos. PBFT ya lo hacía: si el temporizador de una réplica expira en la vista antes de recibir un mensaje new-view válido, la réplica inicia el cambio a la vista , pero esta vez espera el doble de tiempo antes de volver a abandonar la vista. [2] Los timeouts se duplican mientras los cambios de vista sigan siendo consecutivos.
Generalizando, la regla de actualización tras una vista fallida es:
- reproduce la duplicación de PBFT; otros diseños usan factores menores para crecer de forma más suave.
- es un tope de ingeniería que evita esperas absurdas; si se fija por debajo de la cota real, vuelve a introducir el problema de la constante, de modo que debe elegirse con holgura.
- En el ejemplo anterior, con y , la vista 2 espera , más que los de la red, y la propuesta llega antes de que expire el temporizador.
La razón por la que esto funciona es simple: una sucesión geométrica con razón mayor que uno no está acotada. Para cualquier cota finita que necesite una vista después de GST, existe un finito con , y basta con aproximadamente vistas fallidas para alcanzarlo. [1] El costo del error inicial es logarítmico, no indefinido.
Crecimiento suficiente del timeout tras GST
El pacemaker como módulo separado en HotStuff y DiemBFT
El teorema anterior tiene una condición escondida: las réplicas correctas deben estar en la misma vista al mismo tiempo, y esa vista debe tener un líder correcto. Si cada réplica duplica su temporizador por su cuenta y entra en vistas distintas, el crecimiento del timeout no basta.
HotStuff hace explícita esa división de trabajo. El protocolo de votación, con sus QCs y su regla de bloqueo, garantiza safety bajo cualquier patrón de retrasos; un módulo aparte, el pacemaker, se encarga de sincronizar vistas y elegir líderes para que, después de GST, las réplicas correctas coincidan con un líder correcto durante el tiempo suficiente. [3] La política concreta de timeouts vive en ese módulo y puede cambiarse sin tocar el argumento de safety. Los detalles del cambio de vista están en view-change y pacemaker en HotStuff.
DiemBFT, un descendiente productivo de HotStuff, materializa la sincronización con un objeto verificable. Cuando el temporizador de una ronda expira, cada réplica difunde un mensaje de timeout firmado; de esos mensajes forman un timeout certificate (TC). [4] Una réplica avanza a la ronda siguiente al observar un QC o un TC de la ronda actual, de modo que el avance de ronda queda respaldado por un quórum y no por la impaciencia de una réplica aislada. [4]
La combinación es la que da liveness: los certificados alinean a las réplicas en la misma ronda, y el crecimiento del timeout garantiza que, una vez alineadas, la ronda dure lo suficiente.
Impacto Operativo de la Calibración de Timeouts
Un timeout fijo demasiado agresivo en un sistema BFT puede congelar el procesamiento de transacciones durante un episodio de latencia sostenida, aunque todos los nodos estén sanos.
Un pacemaker con timeouts crecientes y avance de vista certificado absorbe los picos de red y recupera el progreso sin intervención manual.
Costos del backoff y decisiones de diseño
El backoff no es gratis. Después de una racha de fallos, el timeout queda alto, y si el siguiente líder está caído, las réplicas esperan más de lo necesario para reemplazarlo. Por eso todo pacemaker necesita una política de descenso: cuándo y cuánto reduce tras observar progreso. Reiniciar al valor base después de cada bloque confirmado reacciona rápido a una red que mejoró, pero puede devolver al sistema al borde del livelock si la latencia sigue alta; reducir gradualmente es más conservador y más lento.
Tampoco hay que confundir capas. El timeout solo decide cuándo abandonar una vista. Lo que se puede votar y confirmar lo deciden los quórums y los locks, y por eso un timeout mal calibrado degrada liveness y latencia, pero no puede producir dos bloques confirmados en conflicto. [3] Esa separación es la que permite experimentar con políticas de timeout sin rehacer la prueba de safety.
Finalmente, el backoff no elimina el costo de esperar timeouts cuando el líder falla; solo garantiza que la espera termine siendo suficiente. La propiedad que HotStuff busca en el caso bueno, avanzar a la velocidad real de la red una vez que hay un líder correcto, se llama responsiveness y se discute en safety, liveness y responsiveness en HotStuff.
Checklist mental de Timeouts BFT
5 de 5 revisados
Bibliografía académica
- [1]
C. Dwork, N. Lynch, and L. Stockmeyer, "Consensus in the Presence of Partial Synchrony," JACM, 1988.
Variantes de sincronía parcial: cota Δ desconocida o cota conocida que solo vale tras GST.
- [2]
M. Castro and B. Liskov, "Practical Byzantine Fault Tolerance," OSDI, 1999.
Duplicación del timeout en cambios de vista consecutivos y safety independiente del tiempo.
- [3]
M. Yin, D. Malkhi, M. K. Reiter, G. G. Gueta, and I. Abraham, "HotStuff: BFT Consensus in the Lens of Blockchain," PODC, 2019.
Separación entre el núcleo de safety y el pacemaker que sincroniza vistas para liveness.
- [4]
The Diem Team, "DiemBFT v4: State Machine Replication in the Diem Blockchain," 2021.
Timeout certificates formados por 2f + 1 mensajes de timeout para avanzar de ronda.
Siguiente lectura
Continúa con view-change y pacemaker en HotStuff para ver cómo el cambio de vista transporta highQC entre líderes, y con safety, liveness y responsiveness para cerrar la discusión sobre cuándo el protocolo avanza a la velocidad real de la red.
Rutas vecinas
Si este tema te abrió hambre, sigue por aquí.
Series y labs que comparten área o dependen de esta ruta. Pocas opciones, para no convertir la curiosidad en menú infinito.
Series relacionadas
Ethereum: de historia a labs
Serie progresiva para entender Ethereum desde el whitepaper, forks y The Merge hasta EVM, Solidity, proof-of-stake, rollups, account abstraction, DeFi, observabilidad y laboratorios reproducibles.
Substrate: del runtime al consenso propio
Serie de 20 capítulos, de neófito a experto, sobre Substrate (Polkadot SDK): runtime en Wasm, FRAME, extrinsics, estado, pesos, actualizaciones sin fork, Aura, BABE, GRANDPA, sincronización, parachains, XCM, Sassafras, BEEFY y cómo conectar un consenso BFT propio a un nodo.
Ruta práctica: activos digitales en la operación
Nueve módulos, de menor a mayor dependencia, para decidir cómo usar custodia, wallets, llaves, firmas multifirma y MPC, AML/KYT y stablecoins con Fireblocks, BitGo, Kaleido, Circle y Tether.
Labs para convertir lectura en práctica
Prueba de trabajo y reajuste de dificultad
Laboratorio determinista para medir el costo de la prueba de trabajo y ver cómo el reajuste por altura de bloque estabiliza el tiempo entre bloques.
Consensus benchmark
Banco reproducible para comparar consenso BFT y documentar los trade-offs de HotStuff-2.
Ethereum local: Anvil, wallet y primera transacción
Laboratorio base para levantar una red local, crear cuentas, firmar transacciones y observar receipts sin gastar ETH real.
RPC y Cast: leer Ethereum con lupa
Ejercicios con JSON-RPC y Cast para consultar bloques, nonces, gas, receipts, logs y errores reproducibles.
Sigue leyendo
Ideas conectadas con este artículo
Una ruta corta para continuar sin abrir veinte pestañas y perder el hilo.
El Pacemaker en detalle: Coordinar relojes en el caos sin sobrecargar la red
Cómo el Pacemaker de HotStuff sincroniza vistas sin tocar safety: rotación de líderes, timeouts locales y certificados de timeout de 2f+1 en DiemBFT.
Safety, liveness y responsiveness en HotStuff
Una separación práctica de las garantías de HotStuff: qué nunca debe pasar, cuándo vuelve a avanzar y por qué responsiveness no significa latencia cero.
View-change en HotStuff: pacemaker, timeouts y líderes tercos
Cómo HotStuff cambia de líder sin perder safety: new-view, highQC, pacemaker y la diferencia entre protocolo de consenso y mecanismo de sincronización.
El dilema de la responsividad optimista en Tendermint: El precio de esperar al temporizador
Por qué el nuevo líder de Tendermint espera la cota Δ antes de proponer y cómo la fase extra de HotStuff permite avanzar a la velocidad real de la red.