HotStuff: de cero a estado del arte
Artículo 32 de 47
68%
completado al llegar aquí
Sistemas distribuidosNota de investigación13 min de lectura
El cuello de botella de la doble transmisión: Por qué los líderes saturan tu fibra
Por qué el líder de PBFT o HotStuff satura su enlace de subida al reenviar el payload completo, y cómo Narwhal separa la difusión de datos del orden total.
Ruta HotStuff: 0/47
Comprende por qué los protocolos BFT basados en líder (PBFT, HotStuff) quedan limitados por el enlace de subida del líder cuando la propuesta transporta el payload completo, y por qué Narwhal separa la difusión fiable de datos del orden total.
- Consenso BFT desde cero (bft-consensus-from-zero)
- HotStuff: QC, highQC y la regla de 3 cadenas (hotstuff-qc-highqc-three-chain)
Detente cuando puedas derivar por qué el throughput de payload de un protocolo con líder queda acotado por la capacidad de subida del líder dividida entre el número de réplicas, sin importar el tamaño del bloque.
Glosario de Notación Matemática y Criptográfica
Cantidad de réplicas maliciosas o con fallas arbitrarias que tolera el sistema.
n = 3f + 1Ruta mental del cuello de botella de doble transmisión
1. Difusión en el mempool (transmisión 1)
De los clientes a las réplicas
2. Propuesta del líder (transmisión 2)
Del líder a toda la red
3. Saturación del enlace de subida
Límite de ancho de banda
4. Desacoplamiento con un DAG
Narwhal y sus consensos
Decodificador Didáctico de Conceptos BFT
En palabras simples: Un periódico que pide a todos los ciudadanos que le envíen sus cartas por correo (transmisión 1), y luego imprime todas esas cartas completas y se las vuelve a mandar a los mismos ciudadanos (transmisión 2).
Detalle técnico: Desperdicio de ancho de banda producido cuando las transacciones se difunden primero en el mempool y luego el líder las transmite nuevamente dentro de la propuesta de consenso.
En palabras simples: Enviar por correo únicamente el número de catálogo de un mueble en lugar del mueble completo, porque todos los ciudadanos ya tienen ese mueble en su almacén local.
Detalle técnico: Arquitectura en la que el consenso acuerda el orden de identificadores criptográficos (digests) cuya disponibilidad ya fue certificada por un quórum.
HotStuff hizo famosa una idea: un protocolo BFT con líder puede mantener la comunicación lineal en el número de réplicas, incluso durante el cambio de vista, gracias a certificados de quórum compactos. [2] Esa linealidad cuenta mensajes y autenticadores. No cuenta bytes de payload.
Cuando un sistema intenta procesar muchas transacciones por segundo, la pregunta deja de ser cuántos mensajes envía el líder y pasa a ser cuántos bytes tiene que empujar por su interfaz de red. Ahí aparece un límite físico que ninguna optimización de fases elimina: el ancho de banda de salida del líder.
Danezis, Kokoris-Kogias, Sonnino y Spiegelman tomaron ese síntoma como punto de partida de Narwhal: separar la difusión fiable de transacciones del protocolo que decide el orden. [1] Este capítulo explica el problema antes de la solución; la arquitectura completa está en Narwhal: mempool DAG para HotStuff.
Dónde gasta bytes un protocolo con líder
En PBFT, el primario asigna un número de secuencia a la petición del cliente y la difunde junto con el mensaje pre-prepare; las réplicas luego intercambian prepare y commit sobre el digest. [3] En HotStuff, el líder de la vista propone un bloque que contiene los comandos y las réplicas devuelven votos que se agregan en un QC. [2]
Los dos diseños comparten un patrón: el mensaje del líder es el vehículo del payload. Los votos son pequeños; la propuesta no. Si un bloque transporta varios megabytes, la propuesta domina el tráfico de cada vista.
A eso se suma un mempool que ya difundió las mismas transacciones. Los clientes envían sus transacciones a uno o varios validadores, y estos suelen retransmitirlas por gossip para que cualquier futuro líder pueda incluirlas. Después, el líder reenvía esos mismos bytes dentro del bloque. Esa es la doble transmisión: la red paga dos veces por mover los mismos datos, y la segunda vez todo el costo cae sobre un único nodo. [1]
Ojo con esto: el problema no es que el líder sea lento o malicioso. Un líder perfectamente honesto y bien provisto sigue siendo un embudo, porque la arquitectura le asigna a él solo el trabajo de difusión que podría repartirse entre todos.
Aritmética del enlace de subida
Hagamos el cálculo con números hipotéticos, elegidos para que la cuenta sea fácil y no como medición de ningún sistema real. Tomemos validadores y una propuesta de de transacciones.
Para que cada réplica reciba la propuesta, el líder debe subir
Si se quisiera un bloque por segundo, el líder necesitaría sostener cerca de de subida dedicados a repetir el mismo contenido. Mientras tanto, cada una de las otras 99 réplicas recibe y sube únicamente votos de unos cientos de bytes. La capacidad de subida agregada del sistema existe, pero está ociosa.
El cuello de botella de subida del líder en consensos tradicionales
Fuentes:
[1]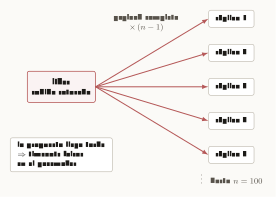
Cómo leer esta figura
El diagrama muestra al líder en el centro intentando empujar megabytes de transacciones a 100 réplicas. El canal de subida se satura, provocando demoras en la entrega de la propuesta y disparando timeouts falsos en el Pacemaker.
La parte interesante aparece al generalizar. Sea la capacidad de subida del líder. El número de bloques por segundo queda acotado por , así que el throughput de payload queda acotado por
El tamaño del bloque desaparece de la cota. Hacer bloques más grandes amortiza la latencia de las fases, pero no compra throughput más allá de ese techo. Y agregar validadores para tolerar más fallas, con , lo empeora: cada validador nuevo es un destinatario más para el mismo enlace.
Cota de subida para propuestas con payload completo (derivación didáctica)
Por qué enviar solo hashes no basta
La reacción natural es recortar la propuesta: que el líder envíe solo los digests de 32 bytes de las transacciones y que cada réplica las busque en su propio mempool. Funciona en el caso feliz. Falla en cuanto el líder es bizantino.
Un líder malicioso puede proponer digests de transacciones que nunca difundió. Las réplicas no pueden distinguir de inmediato entre un dato que todavía no les llegó y un dato que no existe en ningún nodo honesto:
- si votan el bloque, el sistema puede comprometer un orden que nadie es capaz de ejecutar;
- si esperan a tener los datos, dependen de pedírselos al mismo líder sospechoso;
- si fijan un plazo y rechazan, un líder honesto con red lenta pierde su propuesta y el sistema vuelve a depender de timeouts.
Este es el problema de disponibilidad de datos: acordar el orden de referencias solo es seguro si alguien garantiza que el contenido referenciado puede recuperarse. [1] Por eso los protocolos clásicos terminan incluyendo el payload en la propuesta: es la forma más simple de que el voto implique tenencia de los datos, y el precio es el cuello de botella de la sección anterior.
Separar disponibilidad de orden: la respuesta de Narwhal
Narwhal convierte la disponibilidad en un objeto verificable antes de que el consenso intervenga. Cada validador ejecuta uno o varios workers que agrupan transacciones en batches y los difunden a los workers de los demás validadores. El proceso primario del validador no transporta los batches: arma un encabezado de ronda con sus digests. [1]
Ese encabezado se convierte en certificado de disponibilidad cuando reúne firmas de validadores que confirman haber almacenado los datos referenciados. Como a lo sumo firmantes son bizantinos, al menos validadores honestos guardan el contenido y pueden servirlo después. [1]
Los certificados se organizan por rondas: cada nuevo encabezado referencia certificados de la ronda anterior. El resultado es un DAG que registra disponibilidad y causalidad a la vez. [1]
Encima de ese DAG, el consenso ordena digests de certificados. En Narwhal-HotStuff, HotStuff propone y certifica referencias compactas en lugar de bloques con megabytes de transacciones; el paper también presenta Tusk, que ordena el DAG sin mensajes adicionales. [1] [2] Bullshark reutiliza el mismo mempool y cambia la regla de ordenamiento. [4]
Volviendo a la aritmética: si todos los validadores difunden sus propios batches, la subida agregada disponible es del orden de en lugar de , y el throughput de payload deja de estar atado a un único enlace. Además, un validador puede agregar workers en máquinas separadas para aumentar su propia capacidad. Esto también es una cota didáctica, no una cifra del paper.
Qué cambia al desacoplar mempool y consenso
Cuando la propuesta transporta el payload, el enlace de subida del líder fija el techo de throughput del sistema completo.
Separar la difusión fiable de datos del orden reparte la subida entre todos los validadores y deja al consenso ordenando referencias compactas.
Lo que el desacoplamiento no resuelve
Separar capas mueve el problema; no lo hace desaparecer. Vale la pena nombrar los costos antes de leer los números de cualquier evaluación.
Primero, la difusión sigue costando ancho de banda total: cada batch tiene que llegar a muchos validadores. Lo que cambia es quién paga. En lugar de un emisor que sube todo, cada validador sube lo suyo, y el costo se reparte.
Segundo, aparece estado nuevo que mantener: batches, encabezados, certificados y referencias entre rondas. Un nodo que se atrasa necesita sincronizar el DAG, y el sistema necesita una política de recolección de basura que no borre datos que un rezagado todavía necesita.
Tercero, el consenso no se vuelve trivial. HotStuff sobre Narwhal sigue dependiendo de su pacemaker y de timeouts para el progreso bajo sincronía parcial. [2] Tusk elimina esa dependencia con aleatoriedad, y Bullshark busca menor latencia cuando la red se porta bien. [1] [4]
La trampa está en atribuir todo el salto de rendimiento al protocolo de orden. Cuando se compara un protocolo con líder contra uno sobre Narwhal, gran parte de la diferencia viene de la arquitectura de difusión, no de una regla de commit más ingeniosa.
Checklist mental de la doble transmisión
4 de 4 revisados
Bibliografía académica
- [1]
G. Danezis, L. Kokoris-Kogias, A. Sonnino, and A. Spiegelman, "Narwhal and Tusk: A DAG-based Mempool and Efficient BFT Consensus," in Proc. EuroSys, pp. 34-50, 2022, doi: 10.1145/3492321.3519594
Versión publicada en EuroSys 2022 para el DAG mempool y la separación entre disponibilidad de datos y orden total; el ID estable conserva el año del preprint.
- [2]
M. Yin, D. Malkhi, M. K. Reiter, G. G. Gueta, and I. Abraham, "HotStuff: BFT Consensus in the Lens of Blockchain," PODC, 2019.
Fuente central para QC, highQC, Chained HotStuff, view-change lineal y three-chain commit.
- [3]
M. Castro and B. Liskov, "Practical Byzantine Fault Tolerance," OSDI, 1999.
Base práctica para replicación de estado con fallas bizantinas y comparación con fases cuadráticas.
- [4]
A. Spiegelman, N. Giridharan, A. Sonnino, and L. Kokoris-Kogias, "Bullshark," arXiv:2201.05677, 2022.
DAG-BFT de frontera para comparar con Narwhal/Tusk y HotStuff-like ordering.
Siguiente lectura: del embudo al mempool DAG
Continúa con Narwhal: mempool DAG para HotStuff, donde se detalla cómo se forman los certificados y qué ordena finalmente el consenso. Si quieres repasar por qué los QC hacen lineal a HotStuff, vuelve a QC, highQC y la regla de tres cadenas.
Rutas vecinas
Si este tema te abrió hambre, sigue por aquí.
Series y labs que comparten área o dependen de esta ruta. Pocas opciones, para no convertir la curiosidad en menú infinito.
Series relacionadas
Ethereum: de historia a labs
Serie progresiva para entender Ethereum desde el whitepaper, forks y The Merge hasta EVM, Solidity, proof-of-stake, rollups, account abstraction, DeFi, observabilidad y laboratorios reproducibles.
Substrate: del runtime al consenso propio
Serie de 20 capítulos, de neófito a experto, sobre Substrate (Polkadot SDK): runtime en Wasm, FRAME, extrinsics, estado, pesos, actualizaciones sin fork, Aura, BABE, GRANDPA, sincronización, parachains, XCM, Sassafras, BEEFY y cómo conectar un consenso BFT propio a un nodo.
Ruta práctica: activos digitales en la operación
Nueve módulos, de menor a mayor dependencia, para decidir cómo usar custodia, wallets, llaves, firmas multifirma y MPC, AML/KYT y stablecoins con Fireblocks, BitGo, Kaleido, Circle y Tether.
Labs para convertir lectura en práctica
Prueba de trabajo y reajuste de dificultad
Laboratorio determinista para medir el costo de la prueba de trabajo y ver cómo el reajuste por altura de bloque estabiliza el tiempo entre bloques.
Consensus benchmark
Banco reproducible para comparar consenso BFT y documentar los trade-offs de HotStuff-2.
Ethereum local: Anvil, wallet y primera transacción
Laboratorio base para levantar una red local, crear cuentas, firmar transacciones y observar receipts sin gastar ETH real.
RPC y Cast: leer Ethereum con lupa
Ejercicios con JSON-RPC y Cast para consultar bloques, nonces, gas, receipts, logs y errores reproducibles.
Sigue leyendo
Ideas conectadas con este artículo
Una ruta corta para continuar sin abrir veinte pestañas y perder el hilo.
Bullshark: El motor de consenso DAG parcialmente síncrono
Cómo Bullshark ordena el DAG de Narwhal con anclas predefinidas, confirma con f+1 votos en la ronda siguiente y por qué sus timeouts sufren con anclas lentas.
Narwhal: cuando el mempool se vuelve DAG
Por qué Narwhal no es simplemente otro consenso, cómo separa disponibilidad de datos y ordenamiento, y cómo se conecta con HotStuff/Tusk.
La arquitectura de Workers en Narwhal: Desacoplar propagación y orden
Cómo Narwhal divide cada validador en un primary que certifica headers con digests y varios workers que difunden batches, y por qué eso escala el mempool.
El Grafo Dirigido Acíclico (DAG) como una máquina del tiempo inmutable
Cómo el DAG por rondas de Narwhal enlaza cada vértice con 2f+1 certificados previos y por qué Tusk y Bullshark derivan el orden total sin mensajes extra.